同样 $2/$6,xAI 这次真的「做了事」
如果你关注 API 定价,昨天 xAI 悄悄上线了 Grok 4.7——价格一分没涨,但模型下面全换了。
$2/百万输入、$6/百万输出,和 Grok 4.6 一模一样。单看标价,这好像只是又一轮「持续优化」。但看数据,这次真不是微调那么简单。
xAI 说得很直白:Grok 4.7 用了更大的基座模型(具体参数不披露),跑了一轮更长的 RL 训练,训练数据刻意向「需要数小时的困难任务」倾斜。简单说,这不是后训练小修小补——这是一次实实在在的基础模型升级。
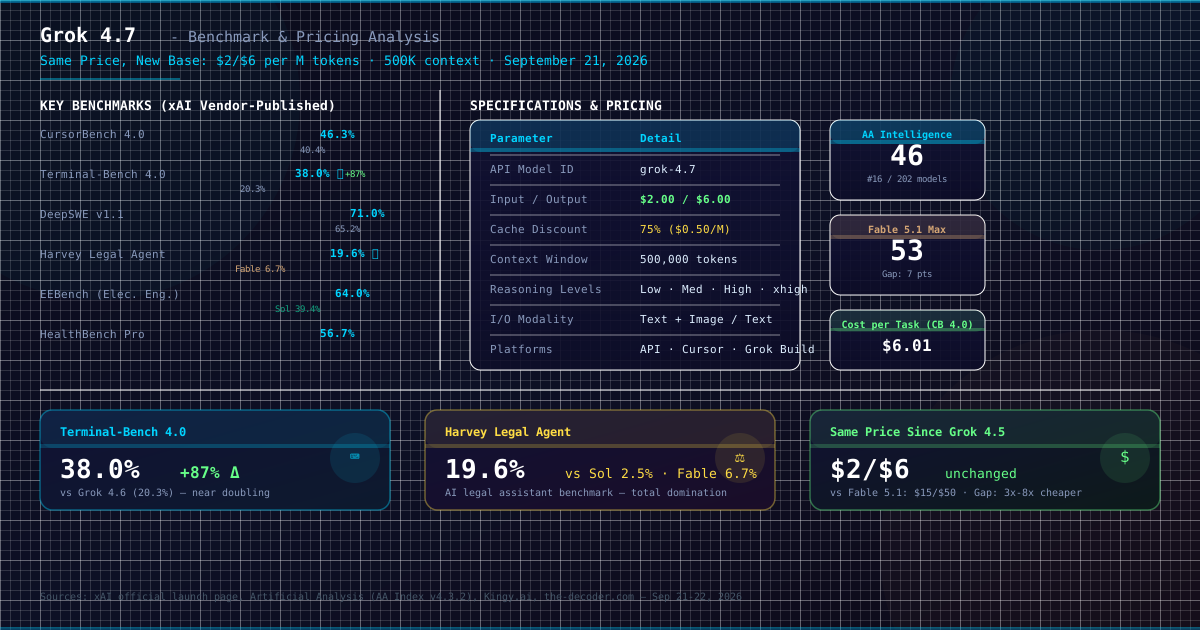
先看基准数据,一张表胜过千言万语:
| 评测 | Grok 4.7 xhigh | Grok 4.6 high | GPT-5.6 Sol max | Claude Fable 5.1 max |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| Terminal-Bench 4.0 | 38.0% 🚀 | 20.3% | 37.3% | 57.9% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| Harvey Legal Agent | 19.6% 💥 | 15.8% | 2.5% | 6.7% |
| EEBench (电气工程) | 64.0% 💥 | 53.0% | 39.4% | 56.4% |
| HealthBench Pro | 56.7% | 48.5% | 60.5% | 62.1% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
数据来源:xAI 官方发布 + Kingy.ai 交叉验证,2026年9月21日。
Grok 4.7 的 DeepSWE 使用 high effort(非 xhigh)。AA Briefcase 报告为分数而非百分比。
这里最值得看的不是平均值,而是分布。
Terminal-Bench 暴涨 87%:xAI 终于学会了「长时间干活」
先说最大的数字。
Terminal-Bench 4.0 是多小时终端任务的基准——让 AI 在终端里跑各种 DevOps 脚本、调试问题、处理系统任务,持续数小时。Grok 4.6 的成绩是 20.3%——算是「及格线挣扎」。Grok 4.7 直接跳到 38.0%,接近翻倍(87% 提升)。
这印证了 xAI 的说法:「训练向数小时任务倾斜」。长 RL 训练在长时间任务上的收益,在后训练(4.6)中没能实现的突破,在新基座模型(4.7)上兑现了。
不过,对比 Fable 5.1 的 57.9%,差距仍然肉眼可见——38% vs 58%,这 20 个百分点的鸿沟不是一轮 RL 能填平的。
有意思的是,Grok 4.7 在这一项上已经追平了 GPT-5.6 Sol(37.3%),甚至略超。$6 的输出价格对战 Sol 的 $20,性价比差距显著。
离谱的法律 Agent 表现:Harvey Legal 19.6% 屠榜
这张表里最让我意外的数字是 Harvey Legal Agent Benchmark。
Harvey 是法律 AI 领域的头部公司(近期刚拿了 $5B 估值),它的 Agent 基准专门测试法律文件分析、合同审查、法律研究等任务。Grok 4.7 在这里跑出了 19.6%——不仅是 Grok 4.6(15.8%)的显著提升,而且是碾压级领先:Fable 5.1 是 6.7%,Sol 是 2.5%。
这种事在 LLM 基准中很少见。通常模型的各维度是正相关的——一个模型如果编码强,推理也强,法律也偏强。Grok 4.7 的 Harvey Legal 表现完全打破了这种关联。这意味着:法律 AI 场景下的「能力曲线」和通用编码场景完全不同,Harvey 的 Agent 框架对模型的「文档长上下文理解和精准信息抽取」提出了独立维度的要求,而 Grok 4.7 在这个维度上找到了自己的独特优势。
对于法律科技公司来说,这是值得认真评估的信号。Harvey 的客户包括 Latham & Watkins、Cooley、K&L Gates 等顶级律所——如果 Grok 4.7 在其框架上表现高出 Fable 5.1 近 3 倍,这可能导致实际工作流中的模型切换。
EEBench 也是惊喜:电气工程 AI 的隐藏冠军
另一个亮点是 EEBench(电气工程基准)。Grok 4.7 的 64.0% 远超 Sol 的 39.4% 和 Fable 5.1 的 56.4%。EEBench 的独特之处在于它测试的是「专业工程文档理解和符号逻辑推理」——这恰好是法律 Agent 也在测的能力。Grok 4.7 在这两个「长文档 + 精确推理」型基准上的双双领先,暗示了基座模型的训练数据中包含了大量高质量的技术文档和工程规范,而非仅仅是代码。
CursorBench 4.0:性价比王者的回归
回到编码赛道,CursorBench 4.0 的数据值得仔细看。
| 模型 + 推理级别 | 得分 | 每任务成本 |
|---|---|---|
| Fable 5.1 Max | 51.8% | $17.28 |
| Fable 5.1 Low | 45.1% | $5.44 |
| Grok 4.7 xhigh | 46.3% | $6.01 |
| Grok 4.7 Low | 33.1% | $1.58 |
| GPT-5.6 Sol Max | 41.7% | $8.23 |
| GPT-5.6 Sol High | 35.7% | $2.85 |
CursorBench 4.0 由 Cursor IDE 发布,测试的是长时间编码任务。数据来源:xAI 发布页。
Grok 4.7 xhigh 以 46.3% 的得分和 $6.01/任务的成本,位于 Fable 5.1 Low(45.1%, $5.44)之上的性价比区间。如果运营团队能容忍略高的成本换取更好的能力,Grok 4.7 xhigh 是目前 Fable 5.1 下方最优的编码 Agent 模型。
而如果你用 Low 推理级别,$1.58/任务的成本几乎可以随意跑大规模测试——33.1% 的成绩相比 Fable 5.1 Low 的 45.1% 有差距,但 $1.58 vs $5.44 的价格差让大规模批处理更可行。
500K 上下文与新推理级别
Grok 4.7 的规格参数上也有一些变化:
- 上下文窗口:500K tokens(和 4.6 一致)
- 输入模态:文本 + 图像
- 输出模态:纯文本(无原生图像生成)
- 推理级别:Low / Medium / High / xhigh(新增)
- 能力:Function calling、Structured Outputs、Web Search、X Search、Code Execution
- 缓存折扣:75%(输入缓存仅 $0.50/百万)
xhigh 是 4.7 新增的推理级别,xAI 文档说 xhigh 比 high 更耗时但更准确。从 CursorBench 数据看:xhigh(46.3%)vs high(43.9%)——差距约 2.4 个百分点,成本增加约 28%。值不值取决于你的场景。
此外,AA Index 上 Grok 4.7 xhigh 得分 46(在 202 个模型的排名中列 #16 Intelligence),但必须注意 AA Index 已升级到 v4.3.2 版本,数字不能和 Grok 4.6 时代的 61 直接比较。单看排名:46 分 #16/202,远高于同类模型的中位数 24。
写在最后:xAI 的第三条路
Grok 4.7 让我看到 xAI 在走一条和 OpenAI/Anthropic 不同的路。
OpenAI 的策略是:Mega 模型(GPT-6 Astra、Sol)+ 高频 API 定价迭代 + 封闭生态。Anthropic 的策略是:优质但昂贵(Fable 5.1 $15/$50——在 CursorBench 上的 $17.28/任务,是 Grok 4.7 的 2.9 倍)+ 强调安全性 + 企业优先。
而 xAI 的选择是:价格不动 + 性能逐代追赶 + 靠刘易斯拐点吸引开发者。
Grok 4.7 的性能并非「最好的」,但它的 $6/百万输出在 Frontier 模型中是极低的。距离 Fable 5.1 在 Terminal-Bench(38% vs 58%)和 Intelligence Index(46 vs 53)上的差距,不是一次升级能填平的。但在法律、电气工程等垂直领域,Grok 4.7 的表现已经超过了 Fable。
如果你是做法律 AI 的,Grok 4.7 可能是当前市场最优选择。如果你在跑大规模编码 Agent,Grok 4.7 Low 的 $1.58/任务成本值得一试。如果你追求「最快的模型」——Grok 4.7 的 38.8 tokens/s 输出速度属于较慢一档(#154/202),大吞吐量场景需注意。
延伸阅读:《Grok 4.6 横空出世!500K 上下文 + $2/百万 tokens》 — 回顾 Grok 4.6 的定价悬崖发现和纯后训练升级故事。
《GPT-6 Astra 横空出世!》 — 对比阅读 Grok 4.7 与 GPT-6 Astra 的能力鸿沟。